چرا سایت در گوگل ایندکس نمیشود؟ ۱۲ علت و روش تشخیص
وقتی صفحهای در گوگل ایندکس نمیشود، اولین واکنش بسیاری از مدیران سایت این است که چند بار روی گزینه «درخواست ایندکس» در سرچ کنسول کلیک کنند. این کار فقط زمانی مفید است که صفحه از نظر فنی قابل دسترس و از نظر محتوایی ارزشمند باشد. اگر سرور پاسخ ندهد، صفحه noindex باشد، canonical به نشانی دیگری اشاره کند یا گوگل صفحه را کمارزش تشخیص دهد، ارسال دوباره درخواست چیزی را اصلاح نمیکند.
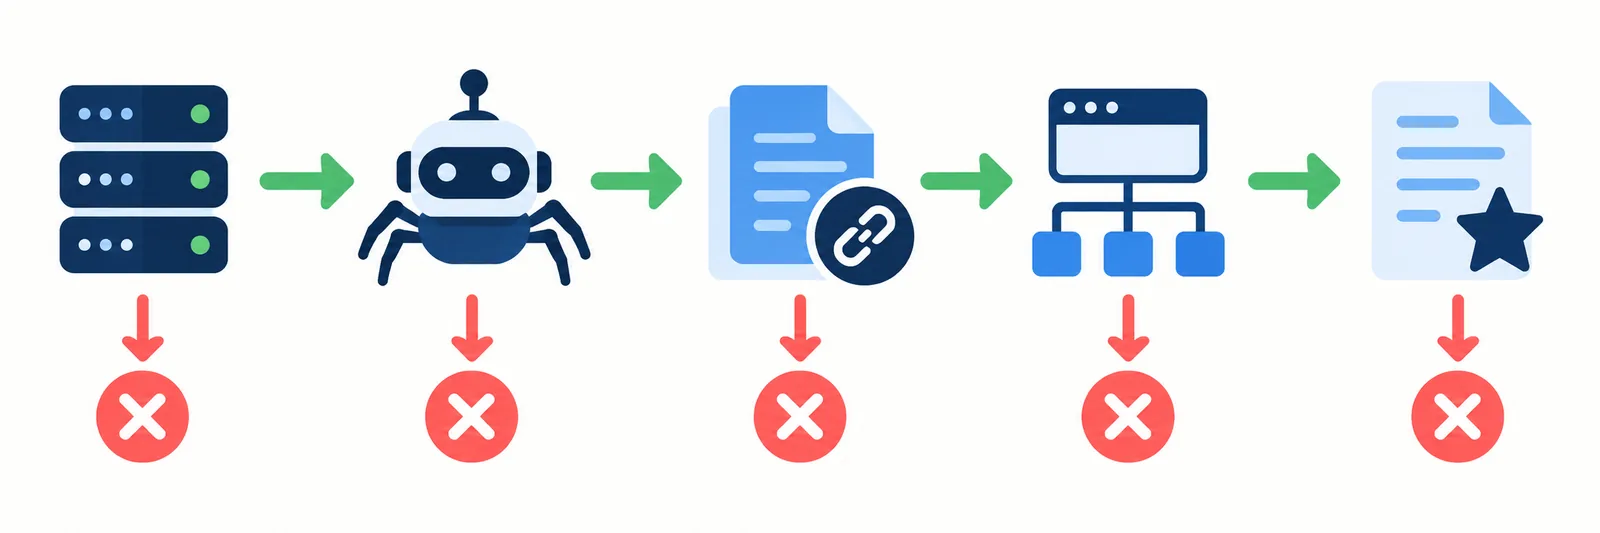
برای حل مسئله باید بین سه مرحله تفاوت بگذاریم: کشف URL، خزش و ایندکس. ممکن است گوگل هنوز نشانی صفحه را پیدا نکرده باشد؛ ممکن است آن را پیدا کرده اما نتوانسته بخزد؛ یا صفحه را خزیده ولی تصمیم گرفته وارد فهرست نتایج نکند. پیام سرچ کنسول و پاسخ واقعی سرور مشخص میکنند مشکل در کدام مرحله است.
اگر نمیخواهید این بررسی را بهصورت دستی انجام دهید، در صفحه آنالیز سئو سایت جزئیات بررسی فنی، محتوایی و وضعیت ایندکس را توضیح دادهایم. اما اگر خودتان دسترسی فنی دارید، مراحل زیر نقطه شروع دقیقی هستند.
پیش از هر کاری: آیا صفحه واقعاً ایندکس نشده است؟
در Google Search Console نشانی کامل صفحه را در ابزار URL Inspection وارد کنید. عبارت «URL is not on Google» بهتنهایی علت را مشخص نمیکند. بخشهای Page indexing و Crawl را باز کنید و این موارد را یادداشت کنید:
- آیا URL برای گوگل شناخته شده است؟
- آخرین زمان Crawl چه تاریخی بوده است؟
- Page fetch موفق بوده یا شکست خورده است؟
- Crawling allowed و Indexing allowed چه وضعیتی دارند؟
- User-declared canonical و Google-selected canonical یکسان هستند؟
سپس روی Test Live URL بزنید. نتیجه زنده با اطلاعات آخرین خزش فرق دارد. ممکن است خطایی را دیروز برطرف کرده باشید ولی گزارش اصلی هنوز نسخه قبلی را نشان دهد. آزمون زنده مشخص میکند گوگل همین حالا چه میبیند.
۱. سایت یا صفحه پاسخ موفق HTTP نمیدهد
گوگل برای ایندکس کردن یک صفحه معمولاً باید پاسخ 200 OK دریافت کند. خطاهای 500، 502 و 503 نشاندهنده مشکل سرور هستند؛ 404 و 410 میگویند محتوا وجود ندارد؛ و 403 یعنی دسترسی خزنده رد شده است. Timeout و Connection refused حتی اجازه دریافت پاسخ HTTP را نمیدهند.
آزمایش را فقط از مرورگر خودتان انجام ندهید. ممکن است سایت برای شما از کش، شبکه داخلی یا نشست مدیریت باز شود ولی برای کاربران بیرونی و Googlebot قابل دسترس نباشد. وضعیت سرور، فایروال، CDN و گزارش uptime را بررسی کنید. اگر چند URL همزمان خطای سرور دارند، مشکل را در سطح هاست یا وبسرور حل کنید، نه در افزونه سئو.
۲. متای noindex یا هدر X-Robots-Tag فعال است
وجود این کد در HTML به گوگل میگوید صفحه وارد نتایج نشود:
<meta name="robots" content="noindex, follow">همین دستور ممکن است در هدر HTTP با نام X-Robots-Tag ارسال شود و در منبع HTML دیده نشود. این اتفاق بعد از انتقال سایت آزمایشی به دامنه اصلی، فعال ماندن گزینه «از موتورهای جستجو درخواست کن محتوای سایت را بررسی نکنند» در وردپرس یا تنظیم اشتباه افزونههای سئو رایج است.
تنها حذف noindex کافی نیست. پس از اصلاح، کش سایت و CDN را پاک کنید، دوباره Test Live URL بگیرید و مطمئن شوید نسخهای که گوگل دریافت میکند دستور قبلی را ندارد.
۳. robots.txt جلوی خزش را گرفته است
دستور زیر تمام سایت را برای رباتهای سازگار مسدود میکند:
User-agent: *
Disallow: /
مسدود کردن در robots.txt با noindex یکسان نیست. robots.txt مانع خزش محتوا میشود، درحالیکه noindex پس از خزش به موتور جستجو میگوید صفحه را ایندکس نکند. برای صفحات عمومی، فایل را در domain.ir/robots.txt باز کنید و مسیر URL را با قواعد آن تطبیق دهید. مسیرهای مدیریت، نتایج جستجوی داخلی و پارامترهای بیارزش را میتوان محدود کرد؛ صفحات خدمات، دستهبندیهای مهم و مقالات نباید ناخواسته مسدود شوند.
۴. canonical به صفحه دیگری اشاره میکند
تگ canonical به گوگل میگوید نسخه ترجیحی محتوا کدام URL است. اگر مقاله A به صفحه B canonical شده باشد، درخواست ایندکس A معمولاً نتیجه مطلوبی ندارد؛ شما عملاً اعلام کردهاید B نسخه اصلی است.
در کد صفحه به دنبال این تگ بگردید:
<link rel="canonical" href="https://example.com/preferred-url/">برای صفحات منحصربهفرد، canonical باید معمولاً به خود همان URL اشاره کند. دامنه، پروتکل، وجود یا نبود www و اسلش انتهایی باید با نسخه نهایی سایت هماهنگ باشند. تفاوت User-declared canonical و Google-selected canonical نیز هشداری است که ممکن است محتوای شما بسیار شبیه صفحه دیگری باشد.
۵. URL فقط از طریق sitemap معرفی شده و لینک داخلی ندارد
نقشه سایت به کشف URL کمک میکند، اما جای معماری سایت و لینک داخلی را نمیگیرد. صفحهای که از منو، دستهبندی، صفحه مادر یا مقاله مرتبط هیچ لینکی دریافت نمیکند، برای کاربر هم پیدا کردنش دشوار است. چنین صفحهای معمولاً «یتیم» نامیده میشود.
هر مقاله باید از صفحه دستهبندی و حداقل یک یا دو محتوای مرتبط لینک دریافت کند. صفحات تجاری نیز باید از ناوبری اصلی یا صفحات مادر قابل دسترس باشند. برای نمونه، این مقاله علاوه بر دسته «سئو تکنیکال»، باید از مطالب چرا سرچ کنسول ایمپرشن ندارد؟ و سئو تکنیکال چیست؟ لینک بگیرد.
۶. صفحه تازه است و هنوز کشف یا بازخزش نشده است
ایندکس فوری نیست. سایت تازه، دامنه بدون لینک ورودی و صفحهای که در عمق معماری قرار دارد ممکن است دیرتر کشف شود. URL را در sitemap قرار دهید، از یک صفحه معتبر داخلی به آن لینک بدهید و یکبار درخواست ایندکس ثبت کنید. ارسال مکرر همان درخواست سرعت را تضمین نمیکند.
اگر چند روز گذشته و حتی در گزارش Crawl اثری از درخواست نیست، سلامت sitemap و لینکهای داخلی را بررسی کنید. اگر صفحه خزیده شده ولی ایندکس نشده، مسئله احتمالاً کشف نیست و باید سراغ کیفیت، شباهت یا canonical بروید.
۷. محتوا تکراری یا بسیار شبیه صفحه دیگری است
فروشگاهها و سایتهای خدماتی معمولاً چند URL با محتوای تقریباً یکسان میسازند: فیلترها، برچسبها، صفحات چاپ، پارامترهای کمپین، نسخههای HTTP و HTTPS یا خدمات مشابه با متنهای جایگزینشده. گوگل ممکن است یکی را انتخاب و بقیه را با پیامهایی مانند Duplicate without user-selected canonical کنار بگذارد.
به جای تغییر چند واژه، هدف هر صفحه را مشخص کنید. دو صفحهای که به یک نیاز پاسخ میدهند باید ادغام شوند یا تفاوت واقعی در پیشنهاد، مثال، مخاطب و محتوای اصلی داشته باشند. canonical و ریدایرکت ابزار پاککردن معماری ضعیف نیستند؛ ابتدا تصمیم بگیرید کدام URL باید باقی بماند.
۸. صفحه «Crawled – currently not indexed» است
این پیام یعنی گوگل صفحه را دریافت کرده ولی فعلاً آن را برای ایندکس مناسب ندانسته است. خطای فنی قطعی نیست. معمولاً باید ارزش صفحه را نسبت به نتایج موجود بررسی کنید:
- آیا محتوا پاسخ کامل و مشخصی میدهد یا صرفاً مقدمههای عمومی دارد؟
- آیا اطلاعات دستاول، تصویر، نمونه، داده یا تجربهای ارائه میکند؟
- آیا عنوان وعدهای میدهد که متن به آن عمل نمیکند؟
- آیا صفحه عملاً نسخه ضعیفتر محتوای دیگری در همان سایت است؟
- آیا بخش اصلی محتوا در HTML قابل مشاهده است؟
در این وضعیت، اضافه کردن هزار کلمه عمومی راهحل نیست. صفحه باید چیزی ارائه کند که کاربر برای همان سؤال واقعاً نیاز دارد و در نتایج مشابه بهسادگی پیدا نمیشود.
۹. صفحه «Discovered – currently not indexed» است
گوگل URL را میشناسد اما هنوز آن را نخزیده است. این وضعیت در سایتهای بزرگ با تعداد زیادی URL کمارزش، سرور کند یا صفحات فیلترشده بیشتر دیده میشود. تعداد صفحات تولیدشده توسط پارامترها، تقویمها، جستجوی داخلی و تگهای خودکار را کاهش دهید. سرعت و پایداری سرور را بررسی کنید و صفحات مهم را در عمق کمتری از صفحه اصلی قرار دهید.
اگر سایت فقط چند ده صفحه دارد و این وضعیت طولانی شده، ابتدا مطمئن شوید سرور در زمان مراجعه Googlebot خطا یا کندی شدید ندارد.
۱۰. ریدایرکت اشتباه یا زنجیرهای وجود دارد
URLی که به صفحه دیگری ریدایرکت میشود خودش معمولاً ایندکس نخواهد شد؛ مقصد ریدایرکت کاندید ایندکس است. زنجیرههایی مانند A ← B ← C زمان خزش را تلف میکنند و احتمال خطا را بالا میبرند. تمام نسخههای قدیمی باید با یک ریدایرکت مستقیم 301 به نزدیکترین مقصد مرتبط برسند.
ریدایرکت صفحه حذفشده به صفحه اصلی، وقتی جایگزین مرتبطی وجود ندارد، ممکن است soft 404 تلقی شود. در این حالت بهتر است پاسخ واقعی 404 یا 410 بدهید و لینکهای داخلی را اصلاح کنید.
۱۱. محتوای اصلی فقط پس از تعامل یا اجرای ناقص جاوااسکریپت ظاهر میشود
گوگل میتواند بسیاری از صفحات جاوااسکریپتی را رندر کند، اما وابستگی کامل به اجرای اسکریپت، خزش و تشخیص محتوا را پیچیدهتر میکند. در View Source بررسی کنید عنوان، متن اصلی و لینکهای مهم در HTML اولیه حضور دارند یا نه. در URL Inspection نیز اسکرینشات و HTML رندرشده را ببینید.
لینکهای اصلی باید تگ استاندارد <a href="..."> داشته باشند. دکمهای که فقط با رویداد جاوااسکریپت مسیر را عوض میکند ممکن است بهاندازه لینک HTML قابل کشف نباشد. برای سایت خدماتی کوچک، ارائه محتوای اصلی بهصورت server-rendered معمولاً مطمئنتر است.
۱۲. مشکل امنیتی، اقدام دستی یا دامنه تازهانتقالیافته وجود دارد
گزارشهای Manual actions و Security issues را در سرچ کنسول بررسی کنید. هک، صفحات اسپم و بدافزار میتوانند اعتماد و نمایش سایت را آسیب بزنند. همچنین پس از مهاجرت دامنه، تغییر ساختار URL یا انتقال HTTP به HTTPS، نبود ریدایرکتهای صحیح باعث میشود گوگل با مجموعهای از نشانیهای قدیمی و جدید روبهرو شود.
در مهاجرت، هر URL قدیمی باید به همتای دقیق جدید برسد. canonical، sitemap، لینکهای داخلی و نسخههای ثبتشده در ابزارهای تحلیلی باید همگی با دامنه نهایی هماهنگ شوند.
ترتیب پیشنهادی برای رفع مشکل ایندکس
برای جلوگیری از آزمونوخطای بیهدف، این ترتیب را اجرا کنید:
- پاسخ HTTP و دسترسی عمومی صفحه را آزمایش کنید.
noindex، X-Robots-Tag و robots.txt را بررسی کنید.- canonical و ریدایرکت را با URL نهایی تطبیق دهید.
- URL را در sitemap و لینکهای داخلی قرار دهید.
- گزارش و آزمون زنده URL Inspection را مقایسه کنید.
- کیفیت و تمایز صفحه را نسبت به صفحات مشابه ارزیابی کنید.
- پس از اصلاح واقعی، یکبار درخواست ایندکس ثبت کنید.
- نتیجه را در بازه زمانی معقول پایش کنید؛ درخواست را روزانه تکرار نکنید.
جمعبندی
ایندکس نشدن یک «خطای واحد» نیست. گاهی سرور اجازه دسترسی نمیدهد، گاهی سایت خودش با noindex یا canonical مانع میشود و گاهی گوگل صفحه را دیده اما ارزش کافی برای نگهداری در فهرست تشخیص نداده است. بنابراین راهحل باید از شواهد شروع شود: پاسخ سرور، URL Inspection، کد HTML و معماری لینکها.
اگر چندین صفحه مهم شما با وضعیتهای متفاوت خارج از ایندکس ماندهاند، یک آنالیز سئو سایت میتواند مسئله را بر اساس اثر تجاری اولویتبندی کند؛ چون رفع یک خطای قالب که صد صفحه را درگیر کرده، معمولاً مهمتر از درخواست دستی ایندکس برای تکتک URLها است.
پرسشهای متداول
ایندکس شدن یک صفحه چقدر طول میکشد؟
زمان ثابتی وجود ندارد. صفحه ممکن است طی چند ساعت کشف شود یا چند هفته منتظر خزش بماند. قدمت دامنه، کیفیت لینکهای داخلی، پایداری سرور و ارزش محتوا بر این زمان اثر میگذارند.
آیا درخواست ایندکس تضمین میکند صفحه وارد گوگل شود؟
خیر. این درخواست فقط URL را برای بررسی در صف خزش قرار میدهد. تصمیم نهایی به دسترسی فنی، canonical، دستورهای ایندکس و کیفیت صفحه وابسته است.
آیا قرار دادن URL در sitemap کافی است؟
خیر. sitemap کشف را آسانتر میکند، اما لینک داخلی، پاسخ موفق سرور و محتوای قابل ایندکس همچنان لازماند.
آیا robots.txt میتواند صفحه را noindex کند؟
robots.txt ابزار کنترل خزش است، نه روش مطمئن حذف از ایندکس. برای جلوگیری از ایندکس باید اجازه خزش بدهید و noindex ارسال کنید یا صفحه را با احراز هویت محدود کنید.
چرا صفحه من خزیده شده ولی ایندکس نشده است؟
اغلب باید شباهت با صفحات دیگر، کامل بودن پاسخ، محتوای اصلی، canonical و کیفیت کلی را بررسی کرد. عبارت Crawled – currently not indexed الزاماً یک خطای فنی مشخص را نشان نمیدهد.